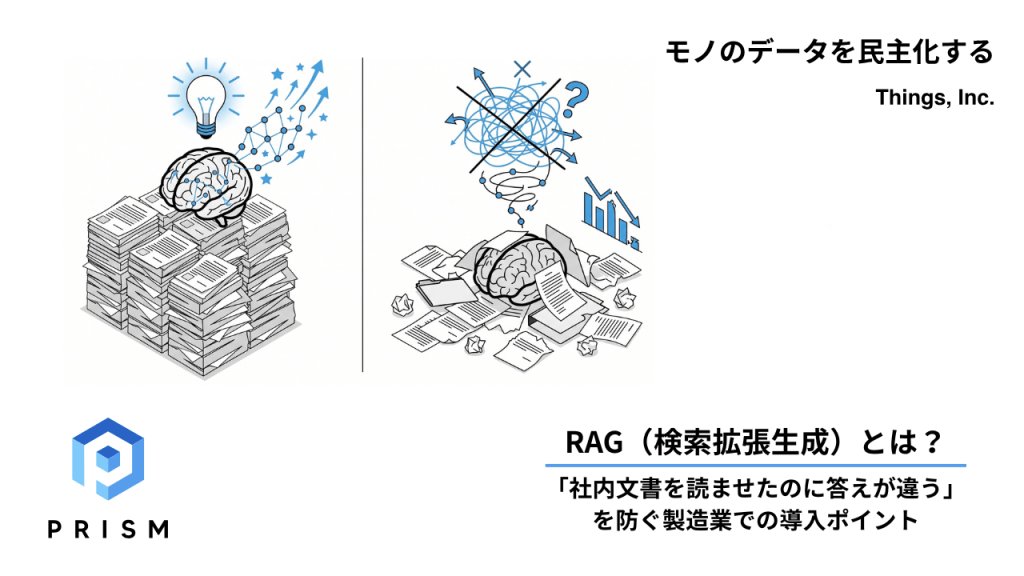
RAG(ラグ、検索拡張生成)とは、生成AIが回答を作る前に社内文書などを検索し、見つけた社内情報を根拠にして回答を作成する仕組みです。自社の規程や過去トラブルのように、ChatGPTなどの汎用AIが学習していない情報について答えさせるための、いま最も一般的な方法です。
ただし、製造業でRAGを試した企業からは「社内文書を読ませたのに、答えが微妙に違う」という声をよく聞きます。原因の多くはAIモデルの性能ではありません。「どの文書を、どの版で、どんな関係づけで渡しているか」というデータ側の整備の問題です。
この記事では、RAGの基本を押さえたうえで、次の3点を製造業の現場目線で整理します。
- 製造業の質問タイプ別に見た「RAGが効く/効かない」の早見表
- RAGの精度低下を「故障モード」として整理した対策表
- 導入前に自社の準備度を測る10項目のセルフチェックリスト
1. RAGとは?一言でいえば「根拠を探してから答えるAI」
RAGは Retrieval-Augmented Generation の略で、日本語では「検索拡張生成」と呼ばれます。Retrieval(検索)で情報を集め、それでGeneration(生成)をAugment(拡張)する、という意味です。
イメージとしては「持ち込み可の試験」です。AIにすべてを暗記させるのではなく、手元に参考資料を置き、該当ページを開いてから答えさせます。生成AIを業務で使うとき、壁は大きく2つあります。
- 自社のことを知らない:自社の設計基準や過去の不具合は、公開データで学習したAIには答えられません。
- 根拠を示せない:もっともらしい誤答(ハルシネーション)が混ざっても、どこが間違いか検証できません。
RAGは、回答のたびに社内文書を検索して渡すことで、この2つを同時に補います。回答と一緒に参照元の文書を示せるため、設計や品質管理のように「根拠のない回答は使えない」業務で特に重視されています。RAGの価値は「AIが賢くなること」ではなく「根拠を持って答えられること」だと押さえておくと、導入の評価軸がぶれません。
2. RAGの仕組み
RAGは、裏側で次の3ステップを踏んで動いています。
| ステップ | やること | 製造業での注意点 |
|---|---|---|
| ① 準備 (インデックス化) |
文書を読み込み、段落などの単位(チャンク)に分割し、意味をベクトル化してデータベースに格納する | PDFの表や図面の注記は崩れやすい。版・品番・機密区分などのメタデータをこの段階で付ける |
| ② 検索 | ユーザの質問に意味が近いチャンクを探す。キーワード検索と組み合わせる「ハイブリッド検索」や、結果の並べ替え(リランキング)で精度を上げる | 品番・図番のような記号は意味検索が苦手。完全一致検索の併用が必須 |
| ③ 生成 | 見つけたチャンクを質問と一緒にAIへ渡し、それを根拠に回答させる。参照元も表示する | 「資料にない場合は分からないと答える」指示を入れ、推測での回答を防ぐ |
ポイントは、AIモデル自体には手を加えない点です。文書を差し替えれば、再学習なしで知識を最新に保てます。
逆にいえば、回答の品質は①②で渡す情報の品質を超えません。
3. ファインチューニング・ロングコンテキスト・AIエージェントとの違い
AIに自社知識を扱わせる方法はRAGだけではありません。よく比較される手法を整理します。
| 手法 | 知識の入れ方 | 得意なこと | 苦手なこと | 知識更新のコスト |
|---|---|---|---|---|
| RAG | 回答のたびに検索して渡す | 大量・頻繁に更新される社内文書、出典の提示 | 検索で拾えない情報、集計 | 低(文書を差し替えるだけ) |
| ファインチューニング | モデルを追加学習させる | 文体・用語・出力形式の統一 | 最新情報の反映、出典の提示 | 高(再学習が必要) |
| ロングコンテキスト | 資料を丸ごとプロンプトに入れる | 少数の文書を深く読む(契約書1本の精査など) | 数千〜数万件の文書、トークンコストを抑えること | 低(ただし毎回の処理量が大きい) |
| AIエージェント | AIが自分でツールや検索を使い分ける | 複数の手順が必要な調査・作業 | 設計・評価が複雑になる | 中 |
実務では二者択一ではなく、「社内知識の参照はRAG、出力の型はプロンプトや軽い調整、複雑な調査はエージェントがRAGを道具として使う」という組み合わせが主流です。エージェントが普及しても、社内知識を正確に引く部分にはRAGの考え方が残ります。
「最新の社内情報を、出典つきで答えさせたい」ならRAGから検討を始め、文体や書式の統一が課題になった段階で他の手法の併用を考えるのが効率的です。
4. RAGの種類
RAGにはいくつかの発展形があります。製造業では「どれが最新か」より「質問の種類に合っているか」で選ぶのが重要です。
| 種類 | 仕組み | 向いている質問のタイプ | 質問例 |
|---|---|---|---|
| ナイーブRAG | 意味の近い文章を検索して渡す基本形 | 答えが文書のどこかに文章で書かれていて、言い回しが違っても意味で探し当てられる問い | 「溶接部の検査手順は?」 |
| ハイブリッドRAG | 意味検索+キーワード完全一致の併用 | 品番・図番・規格番号など、特定の記号や固有名詞を正確に指定して探す問い | 「図番D-20431の表面処理は?」 |
| 構造化データ連携型 | 表やDBをSQLなどで直接引く | 答えが文章ではなく表の項目(数値・属性)として管理されている問いや、件数・合計などの集計を伴う問い | 「この部品の購入先と単価は?」 |
| グラフRAG | 文書や部品の「関係」をたどって検索 | 1つの文書では完結せず、部品同士・文書同士のつながり(親子関係・影響範囲・由来)をたどって初めて答えが出る問い | 「このモーターを変えると影響する製品は?」 |
| エージェント型RAG | AIが検索方法を選び、複数回調べる | 「探す→絞り込む→比べる→まとめる」のように、複数の調査手順を組み合わせないと答えられない問い | 「過去の類似不具合と、そのときの設計対策をまとめて」 |
注目したいのは、下の段に行くほど「文章の中身」ではなく「データの構造」に頼る割合が増える点です。品番の完全一致、部品の親子関係、設計変更の前後関係といった情報は、文書を読み込ませるだけでは生まれません。高度なRAGほど、元データがどれだけ構造化されているかに性能が左右されます。
5. 製造業でのRAG活用シーン:部門別の使いどころ
RAGは「全社の何でも相談窓口」として導入するより、部門ごとの具体的な業務に当てはめた方が効果が見えやすくなります。製造業で成果が出やすい使いどころを部門別に整理します。
| 部門 | 主な活用シーン | 主な参照データ | 期待できる効果 |
|---|---|---|---|
| 設計・開発 | 類似設計の探索、設計基準の確認 | 図面、仕様書、設計基準書、BOM | 流用設計の促進、調べ物の時間削減 |
| 品質保証 | 過去の類似不具合と対策の検索 | 不具合報告書、FMEA、DRBFM、是正処置記録 | 再発防止、なぜなぜ分析の迅速化 |
| 生産技術 | 工程条件・治具情報の確認 | 作業標準書、工程FMEA、QC工程表 | 立ち上げ時の問い合わせ削減 |
| 営業技術・見積 | 過去案件の仕様・対応可否の確認 | 過去見積、顧客仕様書、製品カタログ | 回答リードタイムの短縮 |
| 保守・サービス | 故障時の対処手順の検索 | 保守マニュアル、修理履歴 | 属人的な対応の平準化 |
共通するのは、「ベテランに聞けば分かるが、聞く相手が忙しい・もういない」情報を扱う業務だという点です。RAGは技能継承の手段としても位置づけられます。まずは「問い合わせが特定の人に集中している業務」を1つ選ぶと、効果測定がしやすくなります。
RAG以外も含めた製造業の生成AIの活用領域と事例は『製造業における生成AI活用』でまとめています。
6. RAGの精度が落ちる原因を「故障モード」で整理する
「RAGの精度が出ない」を漠然と捉えると、対策がモデルの乗り換えに偏りがちです。ここでは、製造業でおなじみのFMEAの考え方で、RAGの失敗を「故障モード」として分解します。
| No. | 故障モード | 主な原因 | 現場で起きること | 対策 |
|---|---|---|---|---|
| 1 | 旧版を参照する | 改訂前後の図面・仕様書が同じ場所に混在 | 廃止された寸法で回答される | 版と有効/無効のメタデータを付け、正本だけを検索対象にする |
| 2 | 品番を取り違える | 意味検索は似た記号を「近い」と判断する(A-1203とA-1230など) | 別部品の仕様が返る | 完全一致検索を併用し、品番表記を正規化する |
| 3 | 表・数値を読み落とす | PDFやExcelの表が取り込み時に崩れる | 公差や条件が欠けた回答になる | 表は構造化データとして取り込み、図面は属性を抽出する |
| 4 | 条件と数値が分断される | 分割(チャンク化)で「条件」と「値」が別の塊になる | 前提条件なしの数値が独り歩きする | 見出し単位で分割し、前後の文脈を付けて格納する |
| 5 | 関係が抜け落ちる | 文書同士の紐付けがない | 変更の影響範囲に漏れが出る | BOM・設計変更履歴で部品と文書の関係を明示する |
| 6 | 権限を越えて回答する | アクセス制御が検索に反映されていない | 閲覧権限のない図面が回答に出る | 権限メタデータで検索結果をフィルタする |
| 7 | 「なぜ」に答えられない | 判断理由がそもそも文書化されていない | 結論だけで設計意図が分からない | 設計レビューやDRBFMの記録を蓄積する |
7つのうち、AIモデルを変えて改善するのはごく一部です。大半は文書の管理状態、つまり「どの版が正しく、何と何がつながっているか」で決まります。自社で起きている誤答を集め、この表のどの番号に当たるかを振り分けてください。対策の優先順位がそのまま決まります。
7. 社内RAG導入の進め方
- 用途を1つに絞る:「全社のなんでも質問AI」ではなく、「品質保証部の過去トラブル検索」のように業務と利用者を限定します。
- 文書を棚卸しし、正本を決める:同じ内容の文書が複数ある場合、どれを正とするかを先に決めます。ここを飛ばすと故障モード1が必ず起きます。
- 構造化とメタデータ付与:品番・版・部門・機密区分などを付けます。手作業では負荷が大きいため、AIによる自動分類の活用が現実的です。
- 評価用の質問セットで検証する:実際の質問と正解を30〜50件用意し、下表の観点で測ります。
- 運用で改善を回す:回答への評価(役に立った/違う)を集め、文書の追加・修正につなげます。RAGは作って終わりではなく、文書の鮮度が精度を決め続けます。
ステップ4で使う評価の観点は、次の4つに絞ると現場でも運用しやすくなります。
| 評価の観点 | 確認すること | よくある落とし穴 |
|---|---|---|
| 検索の的中 | 正解が書かれた文書を拾えているか | 回答だけ見て、検索段階の失敗に気づかない |
| 回答の正確さ | 数値・条件・品番が正しいか | 文章が自然なため誤りを見逃す |
| 出典の正しさ | 示した参照元に本当にその記述があるか | 出典リンクを誰も開いて確認しない |
| 分からないと言えるか | 資料にない質問に推測で答えないか | 「答えない」ことを失敗として扱ってしまう |
特に最初の「検索の的中」を切り分けて測ることが重要です。回答が誤っていたとき、原因が検索(渡した資料が違う)なのか生成(資料を読み違えた)なのかで、打つべき対策がまったく変わるからです。
評価用の質問セットで正答率を50%から80%まで引き上げた実例は、『社内AIの正答率を50%→80%へ』で紹介しています。
8. RAG導入前セルフチェックリスト(10項目)

当てはまる項目を数えてください。
- □ AIに答えさせたい業務と利用者が決まっている
- □ 実際のAIへの質問例を20件以上書き出せる
- □ 対象文書の保管場所が把握できている
- □ 同じ内容の文書について「正本」が決まっている
- □ 図面・仕様書の版(改訂履歴)が管理されている
- □ 品番・図番の表記ルールが統一されている
- □ 部品構成(BOM)がデータとして存在する
- □ 不具合報告の書式が揃っている
- □ 文書ごとの閲覧権限が整理されている
- □ 回答が正しいかを判断できる担当者がいる
8〜10個:PoC(試験導入)に進める段階です。 5〜7個:未達項目のデータ整備と並行して、小さく試しましょう。 4個以下:RAGより先に、文書管理・BOM管理の基盤づくりが効果的です。
9. RAGを活かす土台としてのPRISM
ここまで見てきたとおり、製造業のRAGの精度は「AIが参照するデータが整っているか」で決まります。
PRISMは、部品表(BOM)を中核に、図面・仕様書・検査記録・不具合情報などの製品情報を一元管理する製品ナレッジ活用基盤です。アップロードした文書をAIが自動で解析・分類・構造化し、AIが参照できる正確な記録(System of Record)として機能します。
- 版と正本の管理により、旧版参照(故障モード1)を防ぐ
- BOMによる部品と文書の紐付けにより、影響範囲の質問(故障モード5)に答えられる土台をつくる
- AIによる自動分類・タグ付けにより、手作業では追いつかないメタデータ付与(ステップ3)を省力化する
- 生成AIアシスタントが、蓄積された設計資産を根拠に設計判断やトラブル対応を支援する
前述の故障モードの多くは、AIモデルではなくデータ管理の見直しで防げます。自社の図面・BOM・不具合情報をどのようにAI活用につなげられるか、PRISMのサービス資料で詳しくご確認いただけます。

よくある質問
Q. RAGとChatGPT,Gemini,Claudeなどの汎用AIは何が違いますか?
A.汎用AIは主に学習済みの公開情報で答えるAIです。RAGはAIの「使い方」の一つで、ChatGPTのような汎用AIに社内文書を検索して渡し、それを根拠に答えさせる仕組みです。
Q. RAGを使えばハルシネーションはなくなりますか?
A.大きく減らせますが、ゼロにはなりません。旧版や誤った文書を拾えば、それを根拠に誤答します。出典の表示と、人による確認の仕組みを残すことが前提です。
Q. 図面(画像)もRAGの検索対象にできますか?
A.可能ですが、画像のままでは検索しにくいため、表題欄の品番・材質・寸法などを属性として抽出してから扱うのが一般的です。
Q. どのくらいの文書量から効果がありますか?
A.文書量よりも「探すのに時間がかかっているか」が判断基準です。数百件でも、担当者が毎回フォルダをたどって探しているなら効果は出ます。逆に数万件あっても版が混在したままでは、精度が上がりません。
Q. 自社で構築するのとサービスを使うのはどちらがよいですか?
A.自社構築は自由度が高い一方、文書の取り込み・権限管理・評価の運用まで自社で担う必要があります。製造業では文書管理とセットで提供されるサービスを使う方が、立ち上がりは早いです。
まとめ
- RAGとは、生成AIが社内文書を検索し、その内容を根拠に答える仕組み
- 設計・品質・生産技術など、「ベテランに聞けば分かる」情報を扱う業務で効果が出やすい
- 製造業では、質問のタイプによってRAGの向き不向きがはっきり分かれる
- 精度低下の大半は、旧版の混在や関係データの欠落など「データ側の故障モード」が原因
- 導入は用途の絞り込みと正本の決定から始め、検索と生成を分けて評価しながら育てる
製造業×AIの最新動向をメールでお届けします
RAGをはじめ、生成AIの技術や活用の考え方は変化が早く、数か月で前提が変わることも珍しくありません。Thingsのメールマガジンでは、製造業に関わるAIの最新トレンドや国内外の動向、公的機関の調査・白書のポイントを「トレンド解説」として、実務の視点から整理してお届けしています。
情報収集の手間を減らしたい方、社内で生成AI活用を検討されている方は、ぜひご登録ください。
株式会社Thingsが定期配信しているメルマガへのご登録フォームです。
製造業やAI関連のニュース&最新トレンドを詳しく解説しています。